Planlagt CSV-import med status på hver fil
CSV-importen fra et dokumentbibliotek som planlagt flow — status på hver fil, fejl der kan køres igen, tomme filer, danske datoer, decimalkomma og æøå.
Selve opdelingen af en CSV-fil i linjer og felter står i Læs en CSV-fil ind i en SharePoint-liste med Power Automate. Der starter flowet, når en fil lægges i biblioteket. Her er varianten, hvor flowet kører efter en tidsplan og holder styr på hver fil med en status. Efter min erfaring fanger en trigger på upload ikke altid hver fil — en netværksfejl eller et hikke, og filen bliver liggende. Et flow, der kører jævnligt (ned til hvert femte minut) og tager alle nye filer, misser ingen. Samtidig kan en fil, der fejler, sættes tilbage til Ny og køres igen, og det kan ses i biblioteket, hvor hver fil er nået til.
Alt her er standardhandlinger. Intet kræver Premium.
Biblioteket#
Valgkolonnen Status på biblioteket får fire værdier i stedet for tre, med Ny som standard:
- Ny
- I gang
- Færdig
- Fejl
Filteret i flowet skal bruge præcis de samme værdier. Står de på engelsk i biblioteket, skal de stå på engelsk i filteret.
Flowet#
Recurrence hvert 15. minut eller hvad der passer.
Get files (properties only) henter de filer, der venter:
Site Address: [Your SharePoint site]
Library Name: CSVDropoff
Filter Query: Status eq 'Ny'
Order By: Created asc
Top Count: 100
Apply to each over value. Det første i løkken er Update file properties, der sætter Status til I gang, så den næste kørsel ikke tager den samme fil, hvis denne kørsel stadig er i gang:
Id: items('Apply_to_each_-_CSV_file')?['ID']
Status Value: I gang
Resten ligger i en Scope:
- Get file content med
items('Apply_to_each_-_CSV_file')?['{Identifier}']. - Compose CSV som i den anden note, og en Condition på
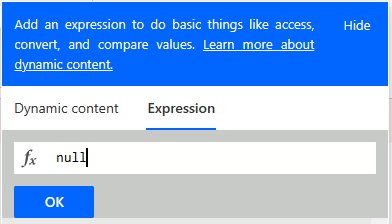
length(outputs('CSV'))større end 0. En tom fil går direkte til Færdig. Betingelsen kan også værebody('Get_file_content')is not equal tonull, og så skalnullskrives som udtryk. Ellers sammenligner flowet med teksten “null”. - Opdelingen i linjer og felter og Create item for hver linje, som i den anden note.
- Update file properties med
StatusFærdig efter løkken over linjerne.
Efter scopet, med Configure run after sat til has failed og has timed out:
Update file properties
Id: items('Apply_to_each_-_CSV_file')?['ID']
Status Value: Fejl
Så ender en fil, der ikke kan læses, som Fejl i stedet for at blive stående som I gang.
En dårlig linje#
Skal én dårlig linje ikke stoppe resten, får Create item Configure run after med både is successful og has failed. Så kører løkken videre, men filen ender som Færdig, selv om linjer mangler. En tællevariabel, der lægges én til, når Create item fejler, og en betingelse før statussen, afgør om den skal være Færdig eller Fejl.
Danske CSV-filer#
Datoer. 31-03-2025 skal være 2025-03-31, før SharePoint forstår den:
concat(
  split(outputs('Compose_-_CSV_Columns_Array')?[2], '-')[2], '-',
  split(outputs('Compose_-_CSV_Columns_Array')?[2], '-')[1], '-',
  split(outputs('Compose_-_CSV_Columns_Array')?[2], '-')[0]
)
Er det 31.03.2025, deles der på . i stedet.
Tal. 1.234,56 skal være 1234.56. Tusindtalspunktummet ud først, så kommaet til punktum:
float(replace(replace(outputs('Compose_-_CSV_Columns_Array')?[3], '.', ''), ',', '.'))
Æ, ø og å. Gemmes en fil i Excel som almindelig CSV (semikolonsepareret), bliver den gemt i Windows’ tegnsæt og ikke i UTF-8. base64ToString læser UTF-8, så æ, ø og å kommer ud som �. base64ToString har ingen parameter til tegnsættet, så det skal ordnes ved kilden: CSV UTF-8 i Excels gem-dialog, eller en eksport, der skriver UTF-8. Skilletegnet i den fil skal tjekkes.
Personer og valg#
Et personfelt ud fra en e-mail. Create item tager e-mailen direkte i personfeltet. Der er ingen grund til at slå brugeren op med Get user profile (V2) først.
Koder til valg. Står der 1, 2 og 3 i filen, hvor listen har High, Medium og Low:
if(equals(outputs('Compose_-_CSV_Columns_Array')?[3], '1'), 'High',
  if(equals(outputs('Compose_-_CSV_Columns_Array')?[3], '2'), 'Medium', 'Low')
)
Hvor kom linjen fra#
To ekstra kolonner på listen, SourceFile (tekst) og ImportDate (dato og tid), gør det muligt at finde en fils linjer igen:
SourceFile: items('Apply_to_each_-_CSV_file')?['{FilenameWithExtension}']
ImportDate: utcNow()
Samme kolonne afslører en fil, der er lagt op to gange: Get items med SourceFile eq '<filnavn>' og Top Count 1 før importen. Kommer der et element, er filen kørt før.
Skal linjenummeret med, er indexOf på linjen ikke nok, for to ens linjer får samme nummer. En løkke over range(0, length(outputs('CSVData'))) i stedet for over linjerne giver nummeret, og linjen er outputs('CSVData')?[item()].
Det der driller#
- En fil, der sidder fast i I gang. Bliver en kørsel afbrudt midt i en fil, kommer den aldrig videre af sig selv. Den skal sættes tilbage til Ny i hånden.
- Status sættes før indholdet hentes. Ellers kan to kørsler tage den samme fil.
- Valgværdierne i filteret skal stå præcis som i kolonnen, også sproget.
base64ToStringkan ikke tegnsæt. Kun UTF-8 kommer igennem uden skader.