System 1 og System 2: hurtig og langsom tænkning i AI
Daniel Kahnemans to systemer for hurtig og langsom tænkning er blevet en måde at tale om AI-modeller på. Hvor idéen kommer fra, hvordan træningen RLHF, RLVR og RLCD passer ind, og hvor langt sammenligningen holder.
Jeg stødte på System 1 og System 2 i dokumentationen til en AI-model, TypeSafes Jev. TypeSafe kalder Jev en “System One”-model og skriver, at navnet kommer fra “the concept Daniel Kahneman popularized in his book Thinking, Fast and Slow” (TypeSafe: System One). Jeg kendte ikke begreberne. Det viste sig, at de har en lang historie i psykologien, og at de er blevet en udbredt måde at tale om kunstig intelligens på.
Hvor kommer det fra?#
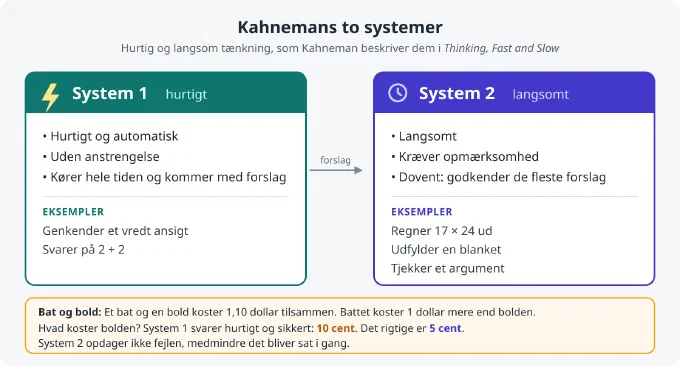
Daniel Kahneman var psykolog og fik Nobelprisen i økonomi i 2002. I 2011 udgav han Thinking, Fast and Slow, som beskriver tænkning som to systemer. System 1 arbejder hurtigt, automatisk og uden anstrengelse. Det genkender et vredt ansigt og svarer på 2 + 2, før man har bedt om det. System 2 er langsomt og kræver opmærksomhed. Det regner 17 × 24 ud, udfylder en blanket og tjekker et argument.
System 1 kører hele tiden og kommer med forslag. System 2 er dovent og godkender de fleste af dem uden at se efter. Bogens mest kendte eksempel: Et bat og en bold koster 1,10 dollar tilsammen. Battet koster 1 dollar mere end bolden. Hvad koster bolden? Svaret, der melder sig, er 10 cent. Det rigtige er 5 cent. System 1 svarer hurtigt og sikkert, og System 2 opdager ikke fejlen, medmindre det bliver sat i gang.
Idéen er ikke Kahnemans egen. Psykologer har talt om to slags processer i tænkningen siden 1970’erne. Peter Wason og Jonathan Evans skrev i 1975 artiklen “Dual processes in reasoning?” (Cognition). Navnene System 1 og System 2 kommer fra Keith Stanovich og Richard West, som brugte dem i en artikel i Behavioral and Brain Sciences i 2000 (Cambridge Core). Kahneman lånte navnene og gjorde dem kendte. Han skriver selv i bogen, at de to systemer er fiktive figurer, en måde at tale om tænkning på, og ikke to steder i hjernen. [bekræft ordlyd og side]
Holder det?#
Ikke alt. Kapitel 4 i bogen bygger på forskning i priming, for eksempel at folk går langsommere efter at have læst ord om alderdom. Den forskning har haft svært ved at blive gentaget. Allerede i 2012 skrev Kahneman til priming-forskerne, at han så “a train wreck looming”. I 2017 gennemgik Ulrich Schimmack, Moritz Heene og Kamini Kesavan de undersøgelser, kapitlet bygger på, og fandt, at 11 af 12 artikler havde for lidt statistisk styrke til at bære konklusionerne (Replicability-Index). Kahneman svarede i kommentarerne, at han havde “placed too much faith in underpowered studies”.
Selve skellet mellem hurtig og langsom tænkning står bedre, men heller ikke uden diskussion. Evans og Stanovich foretrækker i dag at tale om Type 1- og Type 2-processer frem for to systemer, fordi “systemer” lyder, som om der er to adskilte maskiner i hovedet (Perspectives on Psychological Science, 2013). Det er værd at have med, når man låner begreberne til noget helt andet.
Fra psykologi til maskiner#
På NeurIPS-konferencen i 2019 holdt Yoshua Bengio, en af de tre forskere bag det moderne gennembrud i deep learning, foredraget “From System 1 Deep Learning to System 2 Deep Learning” (NeurIPS). Hans pointe var, at deep learning indtil da havde løst System 1-opgaver: genkende billeder, tale og mønstre. Det, der manglede, var System 2: at planlægge, ræsonnere og klare situationer, modellen ikke har set før.
Fem år senere kom modellerne, som bliver kaldt System 2. OpenAI beskrev i september 2024 sin o1-model som en model, der “thinks before it answers”: den skriver en lang tankekæde, før den svarer (OpenAI). DeepSeek-R1 fulgte i januar 2025 (arXiv). De er langsommere og dyrere pr. svar, men bedre til matematik, kode og opgaver i flere trin.
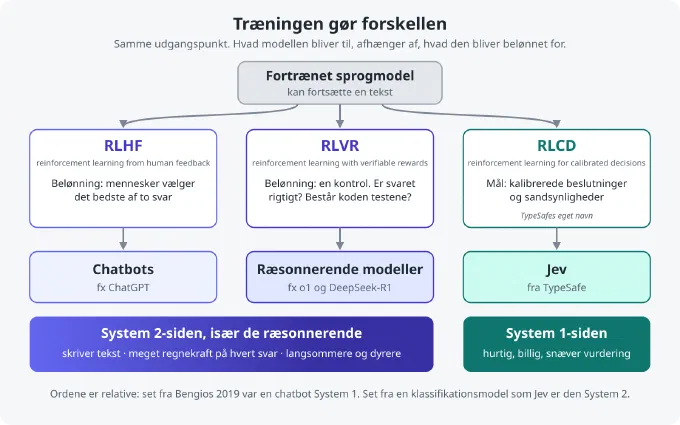
Så i dag bruges ordene nogenlunde sådan: De generative sprogmodeller og især de ræsonnerende modeller er System 2-siden, fordi de bruger meget regnekraft på hvert svar. En System 1-model er det modsatte: en hurtig, billig og snæver model, der ikke skriver tekst, men træffer én afgrænset vurdering. Ordene er relative. Set fra Bengios 2019 var en chatbot System 1. Set fra en klassifikationsmodel som Jev er den System 2.
Træningen gør forskellen#
Man kommer længere med sammenligningen ved at se på, hvordan modellerne bliver trænet. De starter alle som en fortrænet sprogmodel, der kan fortsætte en tekst. Hvad de bliver til, afhænger af, hvad de bagefter bliver belønnet for. TypeSafe beskriver tre veje (TypeSafe: Machine learning primer).
RLHF, reinforcement learning from human feedback. Mennesker sammenligner to svar og vælger det bedste. En belønningsmodel lærer, hvad mennesker foretrækker, og sprogmodellen trænes til at få høj belønning. Metoden blev beskrevet af Paul Christiano og kolleger i 2017 (arXiv) og brugt på sprogmodeller i OpenAIs InstructGPT-artikel fra 2022 (arXiv). Det er den træning, der gjorde sprogmodeller til chatbots som ChatGPT. Ulempen er, at modellen lærer at sige det, folk kan lide at høre. TypeSafe skriver, at RLHF “can also reward sycophancy and confident-sounding hallucinations”: smiger og forkerte svar, der lyder sikre.
RLVR, reinforcement learning with verifiable rewards. Her er belønningen ikke et menneskes smag, men en kontrol: Er svaret på regnestykket rigtigt? Består koden testene? Navnet kommer fra Allen Institute for AI’s Tülu 3-artikel fra november 2024 (arXiv). DeepSeek-R1-artiklen viste, at en model, der kun belønnes for rigtige svar, selv begynder at tjekke og rette sine mellemregninger. Det er den træning, der har givet os de ræsonnerende modeller. Den virker bedst, hvor et svar kan tjekkes, og den giver lange svar, der koster tid og penge. Det er System 2-siden.
RLCD, reinforcement learning for calibrated decisions. Det er TypeSafes eget navn for, hvordan de træner Jev. Det er ikke en fælles standard, og jeg har ikke fundet en forskningsartikel, der beskriver metoden. [bekræft] TypeSafe beskriver målet sådan: “The model does not generate text. It returns decisions and probabilities. Higher probability should correspond to a greater chance that the answer is correct.” Kalibreret betyder, at af alle de svar, modellen giver sandsynligheden 0,8, skal omkring 80 % være rigtige. TypeSafe skriver selv, at det gælder på tværs af mange svar og “does not guarantee that an individual answer is correct” (TypeSafe: System One). Jeg har ikke fundet en offentliggjort måling af kalibreringen i TypeSafes dokumentation. Det er et træningsmål, ikke et målt resultat. Det er System 1-siden: hurtige, snævre vurderinger, der siger, hvor sikre de er.
TypeSafe skriver, at medstifteren Diogo Almeida var med til at opfinde RLHF. Han står som medforfatter på InstructGPT-artiklen.
Jev som eksempel#
Ifølge TypeSafes dokumentation får Jev en tekst og en række spørgsmål med faste svarmuligheder: vælg én af disse, ja eller nej, eller placér på en skala. Den svarer med en sandsynlighed for hver mulighed og skriver ingen tekst. TypeSafe skriver også, at den ikke er bygget til “System Two tasks” med flere lag af indirekte sammenhænge. Den er altså tænkt som et System 1: den giver det hurtige førstebud og siger, hvor sikkert det er. Om det holder på ens egne data, afhænger af, om modellen opfører sig, som dokumentationen beskriver, og det skal man måle selv.
Hvor langt holder metaforen?#
Ikke længere end en metafor. En sprogmodel har ikke to systemer indeni. En ræsonnerende model er den samme slags netværk som en chatbot. Den er bare trænet til at skrive mange flere ord, før den svarer. “System 2” beskriver, hvordan modellen opfører sig, og hvor meget regnekraft den bruger, ikke hvordan den er bygget. Og Kahnemans systemer var selv en forenkling, som psykologerne stadig diskuterer.
Alligevel er sammenligningen nyttig. Den peger på noget, der gælder både for mennesker og maskiner: Det hurtige svar er billigt og som regel rigtigt, men det ved ikke selv, hvornår det tager fejl. Hos mennesker er det System 2’s opgave at gribe ind. Med AI må man bygge det ind selv: lade den hurtige model tage de sikre sager og sende de usikre videre til en langsommere model eller et menneske. Det kræver, at den hurtige model siger, hvor sikker den er, og at man har tjekket, at tallet passer.
Sidst opdateret