Sonnet 5.5 på en almindelig arbejdsdag
Rygtet siger, at Claude Sonnet 5.5 er rigtig god til daglig arbejde. Ti hverdagsopgaver fra SharePoint og Microsoft 365, kørt tre gange hver på Sonnet 5.5, Opus 5.5 og Haiku 4.5: hvor mange holdt, hvor lang tid tog de, og hvad kostede de?
Anthropic udgav Claude Sonnet 5.5 den 28. september 2026 (Anthropic: Claude Sonnet 5.5). Rygtet siger, at den er rigtig god til det daglige arbejde. Anthropic siger det samme på sin egen måde: modellen er “strongest at well-scoped everyday tasks, fixing bugs, and creating polished documents”. Det lyder som en almindelig arbejdsdag for en SharePoint- og Microsoft 365-konsulent, så jeg ville se, om det holder på den slags opgaver, før jeg skifter.
Hvad lover Anthropic?#
Sonnet 5.5 koster 2 dollar pr. million input-tokens og 10 dollar pr. million output-tokens. Opus 5.5 koster det dobbelte, 4 og 20 dollar. Haiku 4.5 koster 1 og 5 dollar. Sonnet 5.5 og Opus 5.5 har begge et kontekstvindue på en million tokens til standardpris (Claude Docs: Pricing, Models overview).
I Anthropics egne benchmarks ligger Sonnet 5.5 tæt på Opus 5.5. På Terminal-Bench 4.0, der måler agentisk kodning, scorer den 70,6 % mod Opus 5.5’s 66,4 %. På GDPval-AA, som tester opgaver fra 44 erhverv, er den 2 point under Opus på en Elo-skala (1844 mod 1846). Anthropic skriver også, at “Opus 5.5 remains clearly stronger at complex, open-ended work requiring sustained judgment”. Det er Anthropics egne tal fra deres egne test. Dem har jeg ikke kunnet efterprøve.
Sådan testede jeg#
Ti opgaver af den slags, jeg selv har på en almindelig dag:
- rette en fejl i en lille Python-funktion, der beregner næste versionsnummer i et bibliotek (majorversion og minorversion, “1.9” bliver til “1.10”)
- skrive et PnP PowerShell-script, der slår versionering til på en liste af sites
- skrive to Microsoft Graph-forespørgsler
- trække kundedata ud af en rodet dansk mail til JSON
- skrive et regulært udtryk til SharePoint-adresser
- skrive en SQL-forespørgsel over lagerforbrug pr. site
- skrive en PowerShell-funktion, der gør filnavne klar til migrering
- finde filer med åbne delingslinks i et udtræk fra Graph
- resumere et engelsk teknisk afsnit på dansk
- skrive et kort dansk svar til en irriteret kunde
De første otte har et svar, der kan tjekkes af en maskine. Koden blev kørt mod tests, SQL’en mod en database med kendt resultat og JSON’en mod et skema. Scriptet og Graph-forespørgslerne blev tjekket mod kravene, men ikke kørt mod en rigtig tenant.1
Hver opgave blev kørt tre gange på hver model, i alt 90 kald. Alle kald gik gennem Claude Code-CLI’en med samme system-prompt og uden værktøjer. Det var modellen alene, der svarede, ikke Claude Code som agent. Sonnet 5.5 og Opus 5.5 kørte begge på effort medium, som er standarden i Claude Code. Haiku 4.5 understøtter ikke effort og kørte med den tænkning, CLI’en slår til.
De to skriveopgaver har ikke et facit. Dem bedømte jeg blindt efter en skrevet rubrik: modelnavnene var skjult, og rækkefølgen var blandet. Selve bedømmelsen blev lavet af Claude Opus 5.5, altså en af de testede modeller. Det tal er en vurdering, ikke en måling.
Hvad viste tallene?#
| Sonnet 5.5 | Opus 5.5 | Haiku 4.5 | |
|---|---|---|---|
| Opgaver med tjek, bestået | 24 af 24 | 24 af 24 | 21 af 24 |
| Dansk resumé, bedømt (af 20) | 18,7 | 18,7 | 11,7 |
| Dansk kundesvar, bedømt (af 20) | 18,7 | 19,3 | 12,3 |
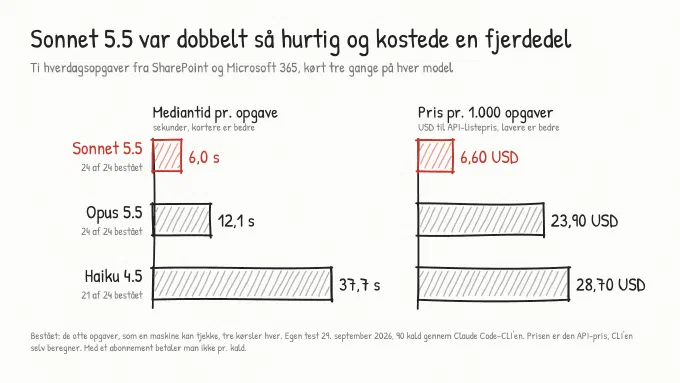
| Mediantid pr. opgave | 6,0 s | 12,1 s | 37,7 s |
| Output-tokens pr. opgave (gns.) | 638 | 1.187 | 5.568 |
| Pris pr. 1.000 opgaver | 6,60 USD | 23,90 USD | 28,70 USD |
Prisen er den API-pris, som CLI’en selv beregner og rapporterer for hvert kald. Med et abonnement betaler man ikke pr. kald, men tallet viser, hvad samme brug koster over API’et til listepris. Hele testen, med prøvekørsler, kostede 2,94 dollar.
Sonnet 5.5 og Opus 5.5 bestod alt. Alle 24 kørsler med et mekanisk tjek holdt for begge modeller. På de to skriveopgaver lå de næsten lige.
Sonnet 5.5 var dobbelt så hurtig og kostede en fjerdedel. Mediantiden var 6 sekunder mod 12 for Opus. Prisen pr. opgave var 28 % af Opus’, selv om listeprisen er det halve. Forskellen er, at Opus skrev næsten dobbelt så meget. PnP-scriptet er et godt eksempel: Opus skrev 161-182 linjer, Sonnet 93-98. Opus’ scripts læste i to af tre tilfælde indstillingerne igen bagefter for at kontrollere, at de var sat. Det er fornuftigt, men det var der ikke bedt om, og det kostede 25 sekunder og 6 cent pr. kørsel mod 8 sekunder og 1 cent.
Haiku 4.5 faldt på Graph og på dansk. Alle tre fejl var i Graph-opgaven: Haiku glemte headeren ConsistencyLevel: eventual, som /users/$count ikke virker uden (Microsoft Learn: Advanced query capabilities). I resuméerne skrev den “lejer” for tenant i to af tre, og kundesvarene var vagere (“det er ikke ideelt”). Den var også både den langsomste og den dyreste. CLI’en kører Haiku 4.5 med udvidet tænkning, og den brugte i gennemsnit 5.220 tænke-tokens på opgaver, som Sonnet 5.5 løste med 201. Uden tænkning ville den sandsynligvis være hurtigere og billigere, men det har jeg ikke testet.
Hvad betyder det for hverdagen?#
På den slags opgaver, jeg testede, gav Sonnet 5.5 det samme resultat som Opus 5.5 på halvdelen af tiden og til en fjerdedel af prisen. Tiden betyder mest. Seks sekunder mod tolv er ikke meget én gang, men det er forskellen på at vente og ikke at vente, når man stiller tyve spørgsmål om dagen.
Prisen er lille for begge. 1.000 opgaver af den størrelse koster 6,60 dollar med Sonnet 5.5 og knap 24 dollar med Opus 5.5 over API’et. Det bliver først et spørgsmål, når en model kører i et flow eller et script, der kalder den tusindvis af gange.
Haiku 4.5 er ikke det billige valg i Claude Code, så længe tænkningen er slået til. Anthropic skriver desuden, at den tidligst udfases den 15. oktober 2026, og at en Haiku 5.5 er på vej (Models overview).
Det, testen ikke kan sige, er, hvornår Opus 5.5 er pengene værd. Mine opgaver var for lette til at skille de to store modeller ad. Til en større migreringsplan eller en fejl, der kræver, at man holder mange ting i hovedet på én gang, er Anthropics egen anbefaling stadig Opus.
Hvad testen ikke siger#
- Den er lille. 10 opgaver og 3 kørsler pr. model. Forskellen mellem 24 og 21 beståede er tre fejl i én opgave.
- Den er min. Opgaverne kommer fra én konsulents hverdag. Andre opgaver kan give andre tal.
- Den er for let til toppen. Sonnet 5.5 og Opus 5.5 bestod alt, så testen måler mest tid og pris, ikke hvem der er klogest.
- Den tester modellen, ikke agenten. Ét spørgsmål, ét svar. Claude Code, der selv læser filer, kører tests og retter sig selv, er ikke testet.
- Indstillingerne betyder noget. På Claude Platform kører Sonnet 5.5 som standard med effort
high, og så vil tider og priser være anderledes. - Skriveopgaverne er en vurdering, lavet af en af de testede modeller.
- Det er ikke en benchmark. Det er ti opgaver, kørt en tirsdag formiddag.
Så holder rygtet? På mine hverdagsopgaver, ja. Sonnet 5.5 løste alt, hvad Opus 5.5 løste, og gjorde det hurtigere og billigere. Den bliver min standard til den slags opgaver, og Opus må vente til de svære.
Sidst opdateret