Hvad man kan bygge med Jev
Jev er en model, der svarer på typede spørgsmål med en sandsynlighed for hvert svar i stedet for at skrive tekst. Her er seks ting, man kunne bygge med den: hvad man sender, hvad man spørger om, hvordan de usikre svar håndteres, og hvor det sidder i et flow, et script eller en app. Alt bygger på TypeSafes dokumentation og på andres test, ikke på egne forsøg.
Når AI bliver bygget ind i et flow i dag, er det næsten altid det samme mønster: send en prompt til en sprogmodel, få en tekst tilbage, og pars teksten, til der står et ord, koden kan bruge. Det virker, men koden skal tolke et svar, der er skrevet til et menneske. Og vil man vide, hvor sikker modellen er, koster det ekstra.
TypeSafe har lavet en model, der er bygget omvendt. Jev skriver ikke. Den svarer på de spørgsmål, man stiller den, i de typer, man selv har defineret, og den giver en sandsynlighed for hvert muligt svar. Det åbner for en anden måde at bygge på, og det er den, dette indlæg handler om: ikke hvad Jev er i teorien, men hvad man kunne bruge den til, og hvordan man ville gøre det.
Én ting først. Jeg har ikke selv kørt Jev mod rigtige data. Alt, hvad der står om modellens egenskaber, er det, TypeSafe dokumenterer, eller det, andre har målt og offentliggjort. Priser og svartider er regnet ud fra TypeSafes offentliggjorte tal og ikke målt. Idéerne herunder er designs, ikke erfaringer.
Hvad Jev er#
TypeSafe kalder Jev en System One-model og beskriver den som “the first System One model” (TypeSafe: System One). Navnet kommer fra Kahnemans Thinking, Fast and Slow, hvor System 1 er den hurtige, intuitive tænkning og System 2 den langsomme. Jeg har ikke fundet andre modeller, der kalder sig System One. Det nærmeste i praksis er en lille klassifikationsmodel, som man selv træner på sine egne mærkede eksempler, men det kræver, at man har de eksempler.
Man sender Jev to ting i ét kald (TypeSafe: API reference):
- en state: det, der skal vurderes, som tekst eller JSON. Det kan være en mail, en sag eller et element fra en liste;
- et sæt spørgsmål, hvert af en af tre typer (TypeSafe: Primitives):
- Choice vælger én af op til 255 muligheder og giver en sandsynlighed for hver af dem;
- Score placerer svaret på en skala med 2 til 10 beskrevne niveauer og giver en fordeling over niveauerne;
- Noul er et ja/nej-spørgsmål og giver ét tal mellem 0 og 1 for ja.
Svaret kommer tilbage som JSON under de nøgler, man selv har valgt. Choice og Score har desuden et felt confidence, der samler fordelingen i ét tal. Ifølge TypeSafe ser alle spørgsmål i samme kald den samme state, men besvares uafhængigt af hinanden: “You can add or remove questions without changing the others’ results” (TypeSafe: Primitives).
Jev skriver ikke svar, laver ikke kode og forklarer ikke, hvordan den kom frem til noget (TypeSafe: System One).
Hvorfor træningen betyder noget her#
TypeSafe beskriver tre måder at efteruddanne en fortrænet sprogmodel på (TypeSafe: AI primer). RLHF, reinforcement learning from human feedback, gav chatbots, der er trænet til svar, mennesker foretrækker. RLVR, reinforcement learning with verifiable rewards, gav de ræsonnerende modeller, der er stærke i fx matematik, men langsommere og dyrere. Jev er ifølge TypeSafe trænet med RLCD, reinforcement learning for calibrated decisions: modellen returnerer beslutninger og sandsynligheder, og “higher probability should correspond to a greater chance that the answer is correct”. RLCD er TypeSafes egen betegnelse og TypeSafes egen beskrivelse af træningen, ikke en målt egenskab. Det er alligevel den del, der betyder mest for idéerne herunder, for de bygger alle på, at sandsynligheden kan bruges til at vælge mellem at handle, spørge og lade være. Holder den ikke, holder tærsklerne heller ikke. Forskellen på de tre og på System 1 og System 2 er beskrevet i System 1 og System 2.
Forskellen fra at prompte en sprogmodel#
Den korte udgave er, at forskellen ligger i formen og ikke i klogskaben.
Der er intet at parse. En sprogmodel skriver tekst. Selv med et JSON-skema er det tekst, der skal tolkes og kan slå fejl. Jev returnerer et typet svar pr. spørgsmål.
Sikkerheden følger med. Vil man vide, hvor sikker en sprogmodel er, må man bede den skrive et tal selv, læse dens token-sandsynligheder, hvor udbyderen tilbyder dem, eller spørge flere gange og tælle. Hos Jev er fordelingen over alle muligheder en del af svaret.
Mange spørgsmål koster næsten ingenting ekstra. Jev koster ifølge TypeSafe $0,042 pr. million input-tokens, og output er gratis (TypeSafe: Models). Spørgsmålene tæller som input, men teksten, der skal vurderes, betales kun én gang pr. kald. TypeSafes eget eksempel med 13 spørgsmål til samme artikel blev 12,2 gange billigere og 10 gange hurtigere, når alle spørgsmål blev stillet i ét kald, uden at svarene ændrede sig (TypeSafe: Parallel questions). Det ændrer, hvordan man designer. Man stiller hellere fem snævre spørgsmål end ét bredt.
Den kan ikke ræsonnere. En sprogmodel kan tænke i flere trin, regne og sammenligne datoer. Det kan Jev ikke, og TypeSafe siger det selv (se grænserne til sidst). Det skal derfor ligge i koden.
Opskriften, der går igen#
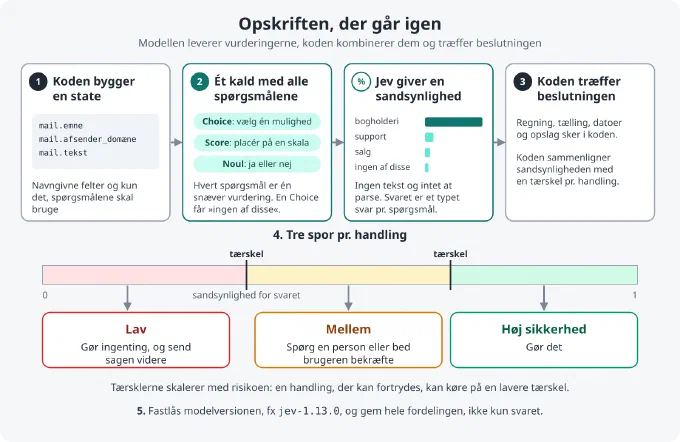
Alle idéerne herunder følger samme form, og det er formen, der er det interessante:
- Koden bygger en state med navngivne felter og kun det, spørgsmålene skal bruge. TypeSafe anbefaler navngivne felter (TypeSafe: State), og et spørgsmål kan pege på et felt ved navn, fx
`mail.emne`(TypeSafe: How to build). - Ét kald med alle spørgsmålene. Hvert spørgsmål er én snæver vurdering. En Choice får en mulighed for “ingen af disse”, for sandsynlighederne summer til 1 over de muligheder, man har givet, og uden en udvej får et input uden for listen en sikker, forkert etiket. TypeSafe anbefaler det, når listen ikke nødvendigvis dækker alt, der kan komme ind (TypeSafe: Primitives). Det er de fleste lister i virkeligheden.
- Koden træffer beslutningen. Alt, der er regning, tælling, datoer og opslag, sker i koden. Modellen leverer vurderingerne, koden kombinerer dem.
- Tre spor pr. handling. Høj sikkerhed: gør det. Mellem: spørg en person eller bed brugeren bekræfte. Lav: gør ingenting, og send sagen videre. TypeSafe kalder det “Thresholds scale with risk”: en handling, der kan fortrydes, kan køre på en lavere tærskel end en, der ikke kan (TypeSafe: Confidence).
- Fastlås modelversionen, og gem alt. Aliaset
jev-latestflytter, når der kommer en ny version, og svarene kan ændre sig uden en ændring hos én selv. TypeSafe anbefaler at bruge versionen, fxjev-1.13.0, når man har tunet tærskler på den (TypeSafe: Models). Gemmer man hele fordelingen og ikke kun svaret, kan en ny tærskel afprøves på gamle sager uden nye kald.
Tærsklerne i eksemplerne herunder er udgangspunkter. De rigtige tal findes kun ved at køre på egne, mærkede eksempler.
Idé 1: Dirreger indgående mails#
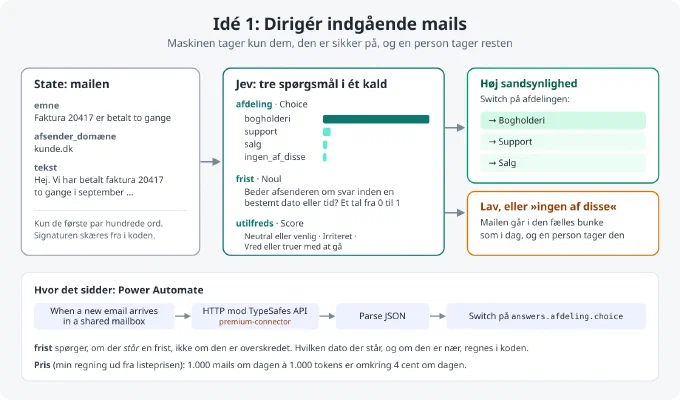
Problemet. En fælles postkasse, hvor nogen hver morgen læser alt og flytter det til den rigtige afdeling.
State. Emne, afsenderens domæne og de første par hundrede ord af brødteksten, med signaturen skåret fra i koden, for ingen af spørgsmålene skal bruge navne og telefonnumre. Ikke hele tråden, for TypeSafe skriver, at præcisionen falder, jo mere irrelevant tekst der er med (TypeSafe: Jev 1.13 jaggedness).
Spørgsmål. En Choice for afdelingen med “ingen af disse”, en Noul for om afsenderen beder om noget inden for en frist, og en Score for hvor utilfreds afsenderen lyder. Som kald ser det sådan ud:
 1{
 2  "model": "jev-1.13.0",
 3  "state": {
 4    "mail": {
 5      "emne": "Faktura 20417 er betalt to gange",
 6      "afsender_domæne": "kunde.dk",
 7      "tekst": "Hej. Vi har betalt faktura 20417 to gange i september ..."
 8    }
 9  },
10  "questions": {
11    "afdeling": {
12      "type": "choice",
13      "instructions": "Hvilken afdeling skal håndtere henvendelsen i `mail`?",
14      "criteria": {
15        "bogholderi": "Fakturaer, betalinger, rykkere og tilbagebetaling",
16        "support": "Fejl i produktet, adgang og brug",
17        "salg": "Priser, tilbud og nye aftaler",
18        "ingen_af_disse": "Henvendelsen hører ikke til nogen af de andre afdelinger"
19      }
20    },
21    "frist": {
22      "type": "noul",
23      "instructions": "Beder afsenderen om svar eller handling inden en bestemt dato eller tid?"
24    },
25    "utilfreds": {
26      "type": "score",
27      "instructions": "Hvor utilfreds lyder afsenderen?",
28      "criteria": ["Neutral eller venlig", "Irriteret", "Vred eller truer med at gå"]
29    }
30  }
31}
Bemærk, at frist spørger, om der står en frist, ikke om den er overskredet. Hvilken dato der står, og om den er nær, er regning og hører til i koden. TypeSafes dokumentation viser, hvordan man lader modellen vælge dag, måned og år hver for sig, med “ikke angivet” som mulighed, og så samler og sammenligner datoen i koden (TypeSafe: Date extraction).
De usikre. Er den højeste sandsynlighed for afdelingen lav, eller vinder “ingen af disse”, går mailen i den fælles bunke som i dag. Maskinen tager kun dem, den er sikker på, og en person tager resten.
Hvor det sidder. I Power Automate: When a new email arrives in a shared mailbox, en HTTP-handling mod TypeSafes API, Parse JSON og en Switch på answers.afdeling.choice. HTTP-handlingen er en premium-connector (Microsoft Learn), og en almindelig Microsoft 365-licens giver kun adgang til standardconnectorerne (Microsoft Learn). Det samme gælder en custom connector. Det er den første udgift at regne med, og den er typisk større end prisen for Jev.
Hvad det koster. Regnet ud fra TypeSafes listepris: en mail på 600 tokens plus spørgsmål på 400 er 1.000 tokens pr. kald. 1.000 mails om dagen er én million tokens, altså omkring 4 cent om dagen. Det er min regning, ikke en måling.
TypeSafe beskriver mønsteret som intent routing: klassificér først, og send kun de sager, der kræver det, videre til en sprogmodel eller en person (TypeSafe: Intent routing).
Idé 2: Tjek, om en indberetning er udfyldt ordentligt#
Problemet. En liste med afvigelser eller ændringsanmodninger, hvor alle felterne er udfyldt, men hvor “Årsag” gentager hændelsen, og “Handling” siger “følges op”. Et påkrævet felt kan ikke se forskel.
State. Felterne fra elementet, hver under sit eget navn: beskrivelse, årsag, handling.
Spørgsmål. Én Noul pr. krav, fordi flere kan fejle på én gang, og en Choice kun kan vælge én:
- Beskriver
årsagen årsag til hændelsen og ikke bare hændelsen selv? - Står der i
handlingen konkret handling, som nogen kan udføre? - Nævner
beskrivelsehvor eller i hvilket system hændelsen skete?
Fristen for handlingen skal være efter oprettelsen, og ansvarlig skal være udfyldt, men det tjekker koden. TypeSafe skriver selv, at Jev læser datoer som tekst og ikke kan sammenligne dem pålideligt (TypeSafe: Jev 1.13 jaggedness).
De usikre. Her er et forkert nej billigt. Den, der oprettede elementet, får en mail med netop det krav, der ikke var opfyldt. Man kan derfor sætte tærsklen for at sende tilbage lavt og lade kvalitetsafdelingen se dem, der ligger i midten.
Hvor det sidder. Et flow på When an item is created på listen, som skriver svarene tilbage i skjulte kolonner. Så kan man også se over tid, hvilke krav der oftest fejler. Afvigelsesappen fra SharePoint-liste eller Dataverse er et oplagt sted.
En advarsel. Spørgsmålene skal skrives præcist. TypeSafe skriver, at Jev “answers the question you wrote, not the one you meant” og læser afgrænsningsord og negationer bogstaveligt (TypeSafe: Jev 1.13 jaggedness). Kanttilfældene skal stå i criteria.
Idé 3: Prioritér leads eller henvendelser efter flere mål#
Problemet. En liste med virksomheder eller henvendelser, der skal sorteres efter, hvem man skal ringe til først. Det er sjældent én ting, der afgør det.
State. Virksomhedsbeskrivelsen og henvendelsen, og en beskrivelse af den kunde, man leder efter, i et felt for sig. Ikke navne på personer, når spørgsmålene ikke skal bruge dem.
Spørgsmål. En Score pr. mål, fx hvor godt branchen passer, hvor moden virksomheden virker til den slags løsning, og en Noul for om henvendelsen udtrykker et konkret behov.
Kombinationen. Koden vægter svarene og lægger dem sammen. TypeSafe kalder det composite scoring (TypeSafe: Composite scoring). Pointen er, at vægtene ligger i koden. Salg kan ændre, hvor meget branche tæller i forhold til modenhed, og sortere igen på de gemte svar uden et eneste nyt kald. Virksomhedsbeskrivelsen er ofte skrevet af virksomheden selv, og TypeSafe skriver, at tekst, der argumenterer for sin egen klassifikation, kan flytte svaret (TypeSafe: Jev 1.13 jaggedness). Rangeringen er derfor god til at sortere, men bør ikke alene afgøre, at en henvendelse bliver sorteret fra. Man skal heller ikke bruge Score-værdien som et målt tal. TypeSafe skriver, at niveauerne er “weak in numerical calibration” (TypeSafe: Jev 1.13 jaggedness). Den er god til at rangordne og sammenligne med en grænse, ikke til at regne på.
Hvor det sidder. Et script, der kører om natten på et udtræk fra CRM’et og skriver tre kolonner tilbage. Der er ingen grund til at gøre det i realtid.
Idé 4: En vagtpost foran en sprogmodel eller en agent#
Problemet. En chatbot eller en agent, der kan kalde værktøjer. Reglerne står i systemprompten, og det er netop der, et forsøg på at snyde modellen rammer.
State. Brugerens besked, og for en agent det værktøjskald, den har tænkt sig at lave, med argumenter.
Spørgsmål. En Noul pr. risiko: beder beskeden modellen om at se bort fra sine instruktioner, indeholder svaret persondata, sletter værktøjskaldet noget. Og en Score for, hvor stor skaden ville være, hvis man gjorde det. TypeSafes eksempel kører samme slags batteri både før og efter sprogmodellen, med to tærskler pr. risiko: én, hvor handlingen udløses, og en lavere, hvor en person skal kigge (TypeSafe: Guardrails for LLMs).
De usikre. Handlinger, der ikke kan fortrydes, kræver høj sikkerhed, og under den spørger agenten brugeren. TypeSafes eksempel med en bank-assistent lader “vis saldo” køre ved 0,6 og kræver over 0,85 for at godkende en overførsel (TypeSafe: Confidence-gated routing).
Hvor det sidder. I koden rundt om kaldet til sprogmodellen, som en funktion før og en efter.
En advarsel. TypeSafe skriver selv, at Jev ikke behandler state som fjendtlig, og at tekst, der er skrevet for at styre modellen, “can move the answer” (TypeSafe: Jev 1.13 jaggedness). Vagtposten er altså selv til at påvirke. Den kan være et ekstra lag, men aldrig det eneste, der står mellem ukendt tekst og en handling, der ikke kan fortrydes. Rettighederne på det, agenten må røre ved, skal stadig sidde i systemet selv.
Idé 5: Hent en værdi ud af fri tekst#
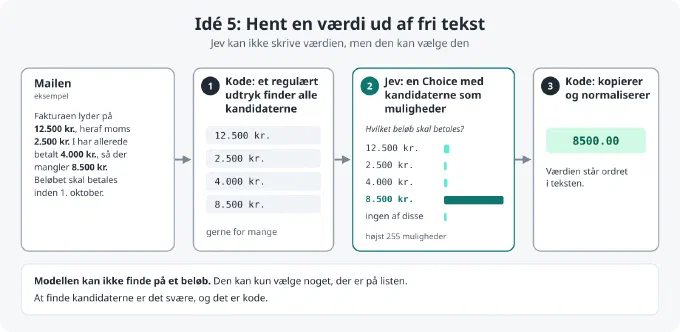
Problemet. Beløbet, der skal betales, står i en mail sammen med tre andre beløb. Eller telefonnummeret til mobilen står sammen med hovednummeret og faxen.
Fremgangsmåden. Jev kan ikke skrive værdien, men den kan vælge den. Et regulært udtryk finder alle kandidaterne, gerne for mange. Jev får dem som muligheder i en Choice, plus “ingen af disse”, og vælger den, spørgsmålet gælder. Koden kopierer den valgte værdi og normaliserer den (TypeSafe: Pre-parsed value extraction). Værdien, man får, står dermed ordret i teksten. Modellen kan ikke finde på et beløb.
Grænsen. Modellen kan kun vælge noget, der er på listen, og en Choice har højst 255 muligheder. At finde kandidaterne er det svære, og det er kode.
Hvor det sidder. Hvor som helst, en værdi i dag bliver skrevet af fra en mail: et flow, der opretter en sag, eller et script, der fylder en tabel.
Idé 6: Klassificér dokumenter#
Det er den oplagte anvendelse, og den er kort her, fordi den ligner idé 1. Dokumenttypen er en Choice med “ingen af disse”, følsomhed en Score, og hvert flag, der kan optræde sammen med andre (persondata, underskrevet, udkast), er en Noul. Datoer, sagsnumre og opbevaringsperioder er kode. Det, der er værd at kende, er et greb fra TypeSafes dokumentation: er modellen usikker på det fine niveau i en klassifikationsplan, melder man det grove niveau over det i stedet for at gætte (TypeSafe: Classification using confidence).
Men om noget er en record, og hvor længe det skal gemmes, afhænger ofte af sagen og ikke af teksten. Det kan ingen model læse i dokumentet. Se grænserne herunder.
Hvor det passer ind#
Jev er ét HTTP-endpoint, POST https://api.typesafe.ai/v1/systemone, med en API-nøgle i headeren (TypeSafe: API reference), og TypeSafe har SDK’er til Python og JavaScript (TypeSafe: Client SDKs). Det giver tre steder at sætte det:
- I Power Automate med HTTP-handlingen eller en custom connector. Begge er premium.
- I et script med SDK’et. Det er det letteste sted at starte, og det er her, man bygger sit testsæt.
- Bag en app som en lille API, der kalder Jev.
TypeSafes egne rate limits er 1.200 kald i minuttet og 250.000 tokens i sekundet, og TypeSafe skriver selv, at de “can change without notice” (TypeSafe: Models). Et flow, der skal køre i morgen, skal kunne klare et svar med 429 Too Many Requests.
Tjenesten er amerikansk. Om jeres data må sendes dertil, er en afgørelse, der skal træffes før første kald, men den hører ikke til i dette indlæg.
De ærlige grænser#
Det meste her står i TypeSafes egen liste over kendte svagheder (TypeSafe: Jev 1.13 jaggedness), resten kommer fra uafhængige test.
Regning, tælling og datoer. Jev “is not a calculator”, tæller ikke pålideligt og læser datoer som tekst. Alt det skal ligge i koden. Vil man tælle, stiller man ét spørgsmål pr. element og lægger svarene sammen selv.
Bogstavelig læsning. Den svarer på det, der står, ikke på det, man mente. Når man selv forklarer, hvad man egentlig mente med et spørgsmål, er forklaringen det, der mangler i spørgsmålet.
Mere tekst er ikke bedre. Irrelevant tekst i state gør svarene dårligere. Filtrér i koden først.
Tekst kan argumentere. Indhold, der er skrevet for at styre modellen, eller som argumenterer for sin egen klassifikation, kan flytte svaret.
Tallet er ikke en sandsynlighed, som det kommer ud. TypeSafe skriver selv, at kalibrering “is measured across groups of predictions; it does not guarantee that an individual answer is correct” (TypeSafe: System One). En uafhængig test fandt “a well-behaved monotone score carrying a stable distortion, not a probability”: tallene rangordner fint, men skal omregnes på egne mærkede eksempler, før 0,9 betyder 90 %. Omkring 50 mærkede eksempler pr. anvendelse fjernede det meste af forskydningen, men under 30 kunne det gøre det værre (jev-exploration). Tærsklerne i idéerne herover virker kun i det omfang, tallene opfører sig sådan.
Sikker, også når svaret ikke står der. En anden test gav Jev en opgave, hvor svaret afhang af en regel, der ikke stod i teksten. Den ramte 44,7 % og gav i snit 0,74 til sit valg (jev-ood-calibration). Samme test anbefaler ikke at sætte tærsklen på feltet confidence, fordi den højeste sandsynlighed aldrig var dårligere. Afhænger svaret af noget uden for teksten, skal det med i state, eller også skal koden afgøre det.
Snævre spørgsmål og en basislinje. I en test af phishing-mails gav ét bredt spørgsmål 62,6 % rigtige. Fem snævre signaler, kombineret i kode, gav omkring 95 %. En ren regel uden AI gav 91,6 % (jev-phishing-bench). Mål altid, hvad man kan nå uden modellen. Samme test fandt, at 2,2 % af svarene skiftede mellem to ens kørsler.
Engelsk først. “English is the primary training language and where accuracy is currently best”, og andre sprog “are handled but not equally well” (TypeSafe: Models). Dansk er ikke målt nogen steder, jeg har fundet. Alle eksemplerne herover er på dansk og skal testes på dansk.
Ingen forklaring. Modellen kan ikke sige hvorfor. Den, der tager de usikre sager, må selv læse dem.
En trænet model kan være bedre. Har man tusinder af mærkede eksempler, kan en lille model, der er trænet på dem, slå Jev. I en test på korte engelske tekster vandt en fintunet DistilBERT på to af tre datasæt (jevbench). Jevs fordel er, at den kun kræver en beskrivelse af mulighederne.
Så#
Det, der gør Jev interessant, er ikke, at den er klogere end en sprogmodel. Det er den ikke. Det er, at svaret har en form, koden kan handle på, og at hvert spørgsmål er så billigt, at man kan stille mange snævre spørgsmål i stedet for ét bredt. Det giver en bestemt måde at bygge på: koden ejer beslutningen og al regning, modellen leverer vurderingerne, og de usikre sager går til en person eller en større model i stedet for at blive gættet.
Sidst opdateret